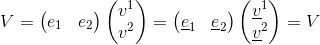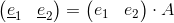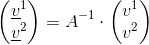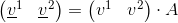domenica 23 giugno 2019

Il Teorema di Bayes e... un Test!

Per derivare il teorema di Bayes o teorema della probabilità delle cause, dovuto al reverendo Thomas Bayes (1702-1761), dobbiamo innanzitutto introdurre la definizione di probabilità condizionata (vedi Wikipedia):
"In teoria della probabilità la probabilità condizionata di un evento A rispetto a un evento B è la probabilità che si verifichi A, sapendo che B si è verificato"; la indicheremo di seguito con il simbolo P(A|B) (viceversa con P(B|A) indicheremo la probabilità di B quando A è noto).
Nota: è chiaro che la conoscenza dell'evento B non cambia l'esito di A ma solo la sua probabilità di verificarsi*.

È inoltre utile definire in modo preliminare quello che nel calcolo delle probabilità viene chiamato spazio campionario (vedi Wikipedia):
"Lo spazio campionario S o insieme universo è l'insieme dei possibili risultati di un esperimento casuale"; ad esempio, nel caso del lancio di un dado a sei facce, è l'insieme dei sei elementi {1, 2, 3, 4, 5, 6} cioè S=6.

Per dimostrare il teorema di Bayes introduciamo quindi il seguente grafico dove, all'interno di un universo S di possibili eventi, sono definiti:
- l'insieme A: che contiene gli elementi (x+y) che corrispondono all'evento dato A (ad esempio il lancio di un dado);
- l'insieme B: che contiene gli elementi (y+z) che corrispondono all'evento dato B (ad esempio l'uscita di un numero dispari nell'evento A).
Inoltre supponiamo che gli eventi A e B siano dipendenti, cioè che il verificarsi di uno cambi la probabilità di verificarsi dell'altro*.
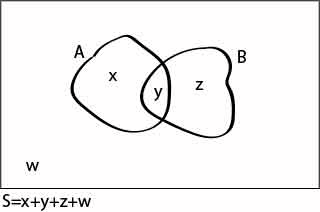

Quindi per definire la probabilità P(A|B) che accada l'evento A noto l'evento B (o viceversa la probabilità P(B|A)) basta osservare che y rappresenta la parte di elementi comuni ad A e B e quindi (vedi grafico):
P(A|B)=y/(y+z)   o viceversa   P(B|A)=y/(x+y).

Inoltre se indichiamo con S lo spazio di tutti i possibili eventi avremo S=x+y+z+w (dove w indica gli elementi non compresi in A o in B) e quindi la probabilità di verificarsi di A e di B è:
P(A)=(x+y)/S   e   P(B)=(y+z)/S
cioè P(A) e P(B) esprimono il rapporto tra i casi favorevoli e quelli possibili.

A questo punto è semplice ottenere la formula di Bayes:
P(A|B)=P(B|A)*P(A)/P(B)
basta infatti sostituire i valori delle varie probabilità (viste sopra) per verificare questa relazione.

Ma vediamo, come esempio significativo, quello di un test diagnostico: consideriamo ad esempio l'esame di una data patologia, il cui rischio di ammalarsi della popolazione è già stato misurato ed è pari all'1%.
Nota: nella interpretazione bayesiana la probabilità P(malato)=1% può non essere nota a priori ma solo presunta e aggiornata in funzione dei risultati.

Stabiliamo quindi l'uso dei seguenti simboli:
P(+): indica la probabilità che il test abbia esito positivo;
P(malato): definisce la probabilità che il paziente sia malato;
P(+|malato): è la probabilità che il test sia positivo se il paziente è malato;
P(malato|+): è la probabilità che il paziente sia malato se il test è positivo.

Inoltre poiché un test non è mai certo al 100%, supponiamo che gli esiti positivi o negativi del test in seguito rivelati infondati, siano i seguenti:
P(+|sano)=7% (falsi positivi: sono i test errati nel riscontrare la malattia);
P(-|malato)=10% (falsi negativi: i test errati nel non rivelare la malattia).

Applicando la formula di Bayes si può quindi calcolare P(malato/+) cioè la probabilità che il paziente sia malato quando il test risulta positivo:
P(malato/+)=P(+|malato)*P(malato)/P(+)
dove sappiamo già che:
P(+|malato)=90% (poiché per il 10% dei malati si ha un falso negativo);
P(malato)=1% (dato che questo è il dato verificato per la popolazione).

Dobbiamo perciò calcolare la probabilità P(+) che il test abbia esito positivo. Per questo si devono sommare le probabilità condizionate con esito positivo del test (cioè P(+|sano) e P(+|malato)), che vanno moltiplicate rispettivamente per le probabilità che il paziente sia sano oppure malato (cioè P(sano) e P(malato))**. In sintesi possiamo scrivere:
P(+)=P(+|sano)*P(sano)+P(+|malato)*P(malato)=7,83%
essendo come già descritto sopra:
P(+|sano)*P(sano)=(7%)*(99%)   e   P(+|malato)*P(malato)=(90%)*(1%).

Siamo infine in grado di calcolare P(malato/+) in termini percentuali con la formula di Bayes:
P(malato/+)=(90%)*(1%)/(7,83%)=11,49%
che è una probabilità piuttosto bassa che il paziente sia malato quando il test risulta positivo, contrariamente alla nostra aspettativa***.

È quindi evidente come il test diagnostico dell'esempio (con quei dati valori di falsi positivi e negativi) non sia sufficiente per stabilire, con una probabilità significativa, la malattia del paziente!

(*) Ad esempio sapendo che il lancio di un comune dado ha dato esito dispari, la probabilità a posteriori di indovinare il numero uscito sarà di 1/3 e non più di 1/6 come supposto a priori prima del lancio. Infatti in riferimento al grafico avremo S=6, x=0, y=1 e z=2 da cui P(A|B)=1/3.
(**) Per chiarire come si ottiene P(+) poniamo gli eventi A=malato, B=+ e A=(S-A)=sano (sono gli elementi non contenuti in A). Quindi in riferimento a quanto visto sopra con i diagrammi si ha: P(B|A)=y/(x+y), P(A)=(x+y)/S, P(B/A)=z/(S-A) e P(A)=(S-A)/S perciò essendo P(B)=(y+z)/S si può verificare la relazione di P(B)=P(+) indicata sopra.
(***) È possibile anche fare un calcolo di tipo frequentista. Se consideriamo 1.000 persone, si ha che 10 (1%) sono malate e di queste 1 non risulta al test (10% di falsi negativi); perciò le altre 9 risultano positive al test. Le restanti 990 (99%) sono sane di cui 69,3 risultano positive (7% di falsi positivi); mentre le altre 920,7 risultano negative al test. In definitiva si hanno 9 persone malate e positive al test su un totale di 69,3+9=78,3 positive al test. Quindi risulta P(malato/+)=9/78,3=11,49% come visto sopra.

venerdì 10 maggio 2019

Fisica, modelli, esperimenti e... realtà!

In questo post vogliamo ritornare su un famoso e cruciale esperimento quantistico (vedi il post "Effetto Compton: onda o particella") per mostrare come in fisica, per descrivere fenomeni complessi, si faccia spesso uso di modelli basati su una astrazione semplificata della realtà, cogliendo a volte solo una parte della fisica presente negli esperimenti.

Consideriamo cioè il caso dell'effetto Compton dove il modello idealizzato dell'esperimento è semplice: si ha infatti un unico fotone che colpisce un elettrone libero (in quiete nel sistema di riferimento del laboratorio) e si ipotizza un urto meccanico elastico tra i due corpi dove l'energia cinetica si conserva; inoltre essendo il sistema per ipotesi isolato, anche la quantità di moto si conserva.
Nota: per la descrizione degli urti meccanici tra due corpi vedi il post "L'urto Elastico o Anelastico".

Dobbiamo quindi assegnare al fotone un quanto di energia sia prima (Eγ=hν) che dopo l'urto (Eγ'=hν') oltre ad una quantità di moto sia prima (pγ=hν/c) che dopo l'urto (pγ'=hν'/c); mentre l'elettrone di massa m0 (e massa relativistica m) acquisisce energia cinetica solo dopo l'urto (Ee=mc2-m0c2) oltre ad una ben definita quantità di moto (pe=mv).
Nota: per la definizione di massa ed energia relativistica vedi il post "Derivare la Massa Relativistica".

In definitiva le equazioni di conservazione dell'energia e della quantità di moto sono le seguenti:
Eγ=Eγ'+Ee
pγ=pγ'+pe.
Sostituiamo quindi i valori delle diverse energie e relative quantità di moto e consideriamo ad esempio il caso in cui il fotone colpisce l'elettrone e rincula indietro esattamente da dove è venuto; in questo caso particolare le equazioni si riducono al caso lineare lungo un solo asse:
hν=hν'+(mc2-m0c2)
hν/c=-hν'/c+pe.
Nota: dalla nota equazione relativistica E2=p2c2+m02c4 si ricava (posto m0=0) la relazione tra energia e quantità di moto del fotone: E=pc.

Perciò ricordando che ν=c/λ ed essendo m2c4=pe2c2+m02c4 (vedi il post "Derivare la Massa Relativistica") si ottiene con qualche passaggio che il fotone deve variare la sua lunghezza d'onda λ a causa dell'urto:
∆λ=λ'-λ=2h/m0c.

Nel caso più generale il modello prevede una precisa correlazione tra l'angolo di deflessione φ del fotone e la sua lunghezza d'onda λ'; si ottiene infatti, in modo analogo a prima, la nota equazione (vedi Wikipedia):
∆λ=(h/m0c)(1-cosφ).
Nota: ponendo l'angolo di scattering del fotone φ=π si ottiene di nuovo ∆λ=2h/m0c; mentre per φ=0 non si ha deflessione e quindi ∆λ=0.

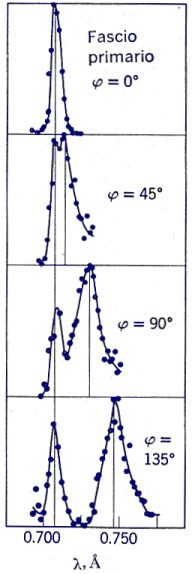
Ora se ripetiamo l'esperimento molte volte troveremo una relazione che possiamo riportare in un grafico e confrontare con la teoria; in particolare lungo l'asse X segniamo la lunghezza dell'onda e lungo Y la sua intensità (cioè il numero di fotoni deflessi) dato che molti sono i fotoni sparati in un dato istante sul bersaglio in cui si trovano gli elettroni.
Nota: nell'esperimento un fascio collimato di fotoni, viene sparato su un bersaglio di grafite ad una ben definita lunghezza d'onda λ.

Ed ecco i grafici ottenuti per alcuni degli angoli di deflessione fissati:
Come risulta evidente dai grafici, i picchi di intensità confermano solo in parte le previsioni del modello; in particolare ci sono due aspetti dei risultati dell'esperimento, non previsti dal modello, che vanno spiegati: 

1) Il bersaglio su cui incidono i fotoni è di grafite quindi è possibile che essi a volte colpiscano atomi di carbonio invece che elettroni, in questo caso la massa m0 che compare in ∆λ=(h/m0c)(1-cosφ) è molto grande e quindi la differenza tra la lunghezza d'onda incidente e quella deflessa tende a zero.
Nota: per questo motivo nelle figure compare sempre un picco che coincide in pratica con quello incidente, oltre a quello deflesso.

2) Gli elettroni bersaglio non si trovano quasi mai in quiete rispetto al laboratorio e quindi la quantità di moto iniziale assume diversi possibili valori, perciò il picco dell'onda non è una unica riga verticale ma è distribuito su diversi valori della lunghezza d'onda.
Nota: poiché (in media) la quantità di moto iniziale dell'elettrone è nulla, il picco massimo rappresenta la media sulle varie lunghezze d'onda.

Tuttavia, nonostante gli evidenti limiti dovuti ad una semplificazione della realtà, il modello non è privo di significato fisico e ci permette di convalidare con buona approssimazione la nostra interpretazione di un urto meccanico relativistico tra corpi quantistici, dandoci una corretta spiegazione dell'esperimento (che valse a Compton il premio Nobel nel 1927).

mercoledì 23 gennaio 2019

Minkowski e lo Spazio-Tempo geometrico

Nel 1908 il matematico Hermann Minkowski dichiarava:
"Le concezioni di spazio e di tempo che desidero esporvi sono sorte dal terreno della fisica sperimentale, e in ciò sta la loro forza. Esse sono fondamentali. D'ora in poi lo spazio di per sé stesso o il tempo di per sé stesso sono condannati a svanire in pure ombre, e solo una specie di unione tra i due concetti conserverà una realtà indipendente" (vedi Wikipedia).

Prima di provare a chiarire questa affermazione introducendo i diagrammi spazio-tempo di Minkowski, che permettono una rappresentazione geometrica delle leggi della Relatività ristretta, dobbiamo dare alcune definizioni:

- Evento: indica un fenomeno fisico localizzato in uno specifico punto dello spazio quadrimensionale in un sistema di riferimento fissato (X, Y, Z, T).

- Punto evento: sono le coordinate istantanee (x, y, z, t) di un evento, cioè un punto preciso dello spazio, nell'istante in cui si verifica il fenomeno fisico.

- Linea di universo: questa linea rappresenta il percorso compiuto dagli oggetti, essa unisce i punti evento corrispondenti alle coordinate istantanee.

In realtà lo spazio-tempo di Minkowski appare come un usuale spazio euclideo, su cui è però definita una distanza ∆s differente da quella euclidea (già introdotta nel post "Tempo Proprio (e paradosso dei gemelli)"):
∆s2=c2∆t2-∆x2
dove ∆x e ∆t indicano rispettivamente gli intervalli di spazio e di tempo tra due eventi in un dato sistema di riferimento inerziale, mentre ∆s è detto separazione spazio-temporale tra gli eventi.
Nota: per semplicità consideriamo solo le coordinate (x, t) dato che le coordinate (y, z) non cambiano passando da un riferimento all'altro.

Inoltre, in modo analogo alla classica distanza dello spazio euclideo, anche l'intervallo ∆s è un invariante per tutti gli osservatori inerziali!
Nota: i diagrammi di Minkowski si applicano solo nell'ambito della Relatività ristretta, cioè in condizioni di spazio piatto (assenza di gravità).

A questo punto possiamo fare dei semplici esempi di linee di universo nello spazio-tempo di Minkowski:

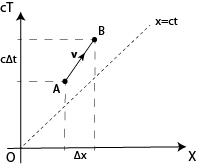
a) Il primo diagramma, descritto dagli assi ortogonali (X, cT), indica la linea di universo di un corpo che si muove tra due punti evento: A (partenza) e B (arrivo) con velocità v minore della luce, come descritto in figura:


In generale si osservi che l'asse cT indica la linea di universo di un osservatore O che non si sposta nello spazio (cioè x=0) ma solo nel tempo; mentre l'asse X indica la linea del suo presente (cioè tutti i punti con t=0).
Nota: se il passato non esiste più e il futuro deve realizzarsi, allora solo il presente comprende tutti gli eventi che definiscono la realtà di O, ma è così?
(Questa posizione filosofica è detta presentismo: solo il presente esiste!)

Si osservi che nel grafico c∆t indica la distanza che percorre la luce nel tempo ∆t (che separa i due eventi A e B); mentre la linea tratteggiata di riferimento indica la linea di universo di un raggio di luce (essendo x=ct).

Nel nostro caso risulta c∆t>∆x quindi i due eventi A e B possono essere connessi casualmente: cioè la distanza ∆x tra i due eventi può essere coperta da un oggetto con velocità v minore di quella della luce: ∆x=v∆t.
Nota: sulla connessione causale tra due eventi vedi il post "Prima la causa e poi... l'effetto?".

La separazione spazio-temporale tra i due eventi è quindi:
∆s2=c2∆t2-∆x2>0
e ciò caratterizza tutti gli osservatori inerziali per i quali l'intervallo ∆s resta invariato (fissati i due eventi A e B); in generale risulta ∆s>0 per tutti gli eventi contenuti in quello che viene definito il futuro di O.
Nota: il futuro di O è formato da tutti i punti dello spazio-tempo che potrà occupare O (cioè i punti compresi tra le due rette x=±ct con t>0).

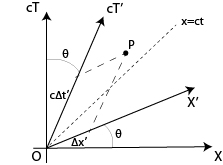
b) In questo secondo diagramma consideriamo invece la linea di universo di un osservatore O' che si muove con velocità v rispetto all'ossevatore in quiete O del diagramma precedente:


Si può facilmente mostrare* che gli assi cT' e X' di O' sono inclinati con la stessa pendenza θ come indicato in figura; inoltre per ottenere le coordinate di un qualsiasi evento P (rispetto a O') basta tracciare le parallele agli assi cT' e X' (come si fa per cT e X nel sistema in quiete O)**.

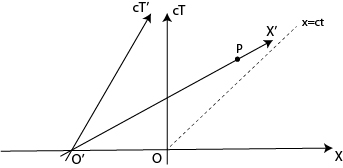
c) Infine in questo terzo diagramma rappresentiamo due osservatori O e O', rispettivamente in quiete e in moto lungo l'asse X, che valutano in modo diverso (a causa della relatività della simultaneità) lo stesso evento fisico P:


Infatti l'osservatore O' si trova sulla linea del presente di O (t=0), mentre l'evento P si trova nel presente di O' (t'=0) e allo stesso tempo si trova nel futuro di O e ciò significa, in modo del tutto inaspettato, che il futuro di O (ad esempio l'evento P) si è già realizzato e fa parte della sua realtà(!)
Nota: in sintesi se O' è reale per O e P è reale per O' allora P è reale (accade) anche per O (se si accetta la proprietà transitiva di realtà tra gli eventi).
(Questo è l'eternalismo: presente, passato e futuro in un unico blocco!)

È probabile che considerazioni come questa fecero scrivere ad Einstein:
"Le persone come noi, che credono nella fisica, sanno che la distinzione tra passato, presente e futuro non è che un'illusione, per quanto tenace"***.
Nota: non esistendo in Relatività un tempo assoluto, il ragionamento precedente si può estendere a qualsiasi punto dello spazio-tempo.

(*) Le trasformazioni di Lorentz per x' e t' sono come è noto: x'=γ(x-vt) e t'=γ(t-vx/c2) quindi posto x'=0 (per ottenere l'asse T') e t'=0 (per ricavare l'asse X') si ha rispettivamente: ct=x(c/v) e x=ct(c/v) perciò la pendenza θ dei due assi T' e X' è la stessa (come indicato in figura) cioè tanθ=v/c.
(**) Il tempo e lo spazio dei due osservatori O e O' non sono direttamente confrontabili sul grafico, in effetti dobbiamo considerare la iperbole di calibrazione ∆s2=c2t2-x2=±1 per confrontare gli intervalli unitari.
(***) Il testo è contenuto in una lettera che Albert Einstein mandò al figlio e alla sorella del suo caro amico Michele Besso, in occasione della sua morte.

[La coordinata t di P nell'ultimo diagramma si deriva dalla relazione t'=γ(t-vx/c2) ponendo t'=0 (che indica il presente di O') da cui segue: t=vx/c2. Ciò significa che per basse velocità v di O' è la variabile x che definisce di quanto P si trovi nel futuro di O (vedi il Paradosso di Andromeda)]  

mercoledì 19 dicembre 2018

Tempo Proprio (e paradosso dei gemelli)

Nel post "La Dilatazione relativa del Tempo" abbiamo mostrato la relazione che lega l'intervallo di tempo ∆t' misurato da un osservatore in moto (con velocità v costante) e lo stesso intervallo ∆t misurato dall'osservatore in quiete cioè solidale con il suo orologio:
∆t=∆t'(1-v2/c2)1/2.
Questa relazione è valida per tutti i sistemi di riferimento inerziali.
Nota: ciò è vero nell'ipotesi della costanza della velocità della luce e dell'invarianza delle leggi della fisica nei sistemi inerziali.

Supponiamo quindi di avere due osservatori in moto relativo lungo l’asse X con velocità v. Uno dei due è solidale con un orologio in quiete nel proprio sistema e misura il suo tempo proprio Δt; l’altro, rispetto al quale l’orologio è in moto, misura per gli stessi due eventi un intervallo Δt′.

Ora ∆t si definisce tempo proprio poiché è quello che viene misurato dall'osservatore in quiete rispetto al fenomeno osservato: nel nostro caso il fenomeno osservato è proprio il tempo ∆t dell'orologio in quiete (posto in un punto fissato x del suo riferimento).

È noto che in fisica classica due eventi qualsiasi che accadono nello spazio e nel tempo (x1, t1) e (x2, t2) definiscono un intervallo spaziale ∆x=x2-x1 e uno temporale ∆t=t2-t1: in particolare le distanze tra punti misurate nello stesso istante risultano invarianti, mentre l’intervallo temporale tra due eventi è lo stesso per tutti gli osservatori inerziali.
Nota: nel nostro caso gli eventi segnano il passaggio dell'orologio in moto da un punto di coordinate (x1, t1) ad un altro punto (x2, t2).

In fisica relativistica si definisce invece un altro tipo di intervallo ∆s che è invariante per tutti gli osservatori inerziali*, ed è una sorta di unione degli intervalli di spazio e di tempo dei due eventi:
∆s2=c2∆t'2-∆x'2
dove ∆x' e ∆t' non sono più assoluti ma dipendono dal moto relativo degli osservatori (secondo le trasformazioni di Lorentz).
Nota: le coordinate (x', t') con l'apice sono quelle dell'osservatore in moto, mentre per quello in quiete col suo orologio risulta ∆x=0 (vedi oltre).

Il fatto interessante è che nel nostro caso l'intervallo ∆s, detto separazione spazio-temporale tra due eventi, si può esprimere nel sistema in quiete (cioè quello dell'osservatore con l'orologio) semplicemente ponendo ∆x=0 (poiché l'orologio si trova in quiete in questo sistema di riferimento):
∆s2=c2∆t2
dove ∆t rappresenta il tempo proprio dell'osservatore in quiete.
Perciò eguagliando le due ultime relazioni risulta:
c2∆t2=c2∆t'2-∆x'2   =>   ∆t2=∆t'2-∆x'2/c2=∆t'2(1-∆x'2/∆t'2c2).

Se quindi ∆x' rappresenta lo spostamento dell'orologio lungo X' e ∆t' il tempo impiegato a spostarsi, avremo che v=∆x'/∆t' indica la velocità relativa tra i due osservatori; perciò si ottiene:
∆t2=∆t'2(1-v2/c2).
Questa è la stessa equazione già ricavata nel post sopra citato da cui risulta ∆t'>∆t: cioè l’intervallo temporale Δt′, misurato dall’osservatore rispetto al quale l’orologio è in moto, risulta dilatato rispetto al tempo proprio Δt segnato dall’orologio stesso nel suo riferimento.
Nota: si ha ∆t'=∆t solo quando v=0 cioè se entrambi gli osservatori sono in quiete uno rispetto all'altro.

Si noti che la relazione ottenuta vale solo per moti inerziali rappresentati da rette nello spazio-tempo (con pendenza v); tuttavia se riduciamo l'intervallo ∆s ad un infinitesimo ds allora si ottiene (in modo del tutto equivalente):
dt=dt'(1-v2/c2)1/2
dove dt e dt' sono i relativi intervalli infinitesimi.

Questo risultato non è banale poiché una traiettoria curva di un moto qualsiasi, quindi in generale non inerziale, possiamo suddividerla in infiniti tempi dt' e spostamenti dx' e perciò in infiniti intervalli ds.

Da ciò segue che l'integrale su tutti i tempi infinitesimi dt restituisce il tempo proprio complessivo dell'osservatore solidale con l'orologio:
∆t=∫dt=∫dt'(1-v(t')2/c2)1/2
da cui si ottiene di nuovo ∆t2=∆t'2(1-v2/c2) se v(t')=costante.
Nota: in pratica è come se suddividessimo la curva del moto in infiniti riferimenti inerziali con velocità istantanea v(t') e intervallo ds.

Si osservi che nel nostro caso dt rappresenta il tempo proprio dell’orologio in moto, poiché, in ogni tratto infinitesimo della sua traiettoria abbiamo posto dx=0 (cioè l'orologio è in quiete con questo riferimento) ed integrato su tutti i dt per ottenere il tempo proprio complessivo.

Dall'integrale sopra si deduce di nuovo che ∆t'>∆t essendo (1-v(t')2/c2)<1, cioè il tempo proprio Δt accumulato dall’orologio in moto è minore del tempo Δt′ misurato dall’osservatore inerziale rimasto in quiete.

L'asimmetria tra i due sistemi risulta evidente solo quando l'osservatore in moto ritorna nel punto di partenza e confronta il suo orologio con quello rimasto in quiete, verificando che ∆t'>∆t (vedi il paradosso dei gemelli).
Nota: si noti infatti che non è possibile il confronto diretto tra due orologi, sincronizzati nello stesso punto, ma poi divisi dal moto relativo inerziale.

Ovviamente se il moto dell'orologio fosse inerziale la situazione sarebbe del tutto simmetrica: le stesse considerazioni si potrebbero applicare all'osservatore in moto che può ritenersi in quiete a tutti gli effetti, supponendo invece in moto l'altro osservatore (per il Principio di Relatività). Perciò è proprio la rottura di simmetria tra i due sistemi che nel nostro caso porta ad esiti verificabili**.
Nota: fatto verificato sperimentalmente ponendo un orologio in moto su un aereo e confrontandolo al rientro con la sua copia rimasta a terra.

Se volessimo studiare il fenomeno dal punto di vista dell'osservatore in moto non inerziale, potremmo utilizzare la teoria della Relatività Generale; si otterranno coerentemente gli stessi risultati sulla dilatazione temporale prima derivati con la sola applicazione della relatività ristretta (come ben mostrato in questo articolo pdf di G.C. D'Amico)***.

(*) Inserendo nel ∆s2 i valori di x' e t' delle trasformazioni di Lorentz si può dimostrare che questo intervallo è un invariante relativistico.
(**) Si può mostrare che l'accelerazione non è la causa della dilatazione del tempo considerando tre osservatori inerziali posti sullo stesso asse: un osservatore in quiete, un secondo in moto inerziale che si allontana e un terzo che si avvicina incrociando quello in allontanamento.
Quando il terzo osservatore incrocia il secondo, sincronizza il suo orologio in volo (senza variare la sua velocità): ebbene anche in questo caso vale la relazione ∆t'>∆t senza che ci siano accelerazioni degli osservatori in moto.
(L'asimmetria è dovuta al fatto che il tempo viene per così dire "trasferito" da un riferimento inerziale all'altro a differenza di quello rimasto in quiete - vedi anche Wikipedia inglese).
(***) In questo caso la situazione non è più simmetrica, poiché l'osservatore è in moto non inerziale e può considerarsi in quiete solo se si introduce un campo gravitazionale fittizio per il principio di equivalenza: è proprio questo campo fittizio che spiega il rallentamento del tempo proprio dt rispetto a dt'!
(Vedi il post "Il Principio di Equivalenza: ma=mg")

lunedì 1 ottobre 2018

Il Principio di minima Azione!

Introduciamo questo post dicendo subito che (vedi Wikipedia):
"In fisica il principio di minima azione è un principio variazionale che stabilisce che nei fenomeni della natura l'azione viene sempre minimizzata. A partire da questo principio si determina l'equazione del moto di un sistema dinamico".

Come mostreremo il principio variazionale di minima azione si definisce grazie al calcolo delle variazioni che è "un campo dell'analisi matematica che si occupa della ricerca dei punti estremali (massimi e minimi) dei cosiddetti funzionali, ovvero funzioni il cui dominio è a sua volta un insieme di funzioni" (vedi Wikipedia).

Consideriamo ad esempio il moto di una particella con legge oraria q(t) e velocità q'(t)=dq(t)/dt); come vedremo possiamo definire una ipotetica funzione L(q,q') detta lagrangiana* del sistema, che è appunto funzione della coordinata q(t) e della velocità q'(t).
Nota: consideriamo per semplicità il caso con una solo coordinata dove q indica una coordinata generale, non necessariamente cartesiana.

Ora per definire l'equazione del moto, introduciamo un'altra funzione S(q(t)) chiamata Azione in cui compare la stessa L(q,q') (in realtà S è un funzionale essendo una funzione di funzione), ed è così definita:
S(q(t))=∫t1t2L(q,q')dt.

Come si vede S(q(t)) dipende dal percorso q(t) compiuto dalla particella (una volta fissati il punto iniziale q(t1) e finale q(t2)); in effetti esistono infiniti percorsi tra q(t1) e q(t2) su cui calcolare S(q(t)) che perciò può variare con continuità, in funzione del percorso.
Nota: questa osservazione ci permette di trattare S(q(t)) come se fosse una funzione (differenziabile) anche se è una funzione di funzione (funzionale).

Facciamo quindi l'ipotesi fondamentale, che la natura sembra sempre rispettare, secondo cui l'equazione del moto della particella si può ricavare ponendo la seguente condizione su S(q):
δS(q)=0.

Tale condizione è del tutto analoga a porre nullo il differenziale dF(r) di una funzione F(r) (a più variabili ma un solo valore) per trovare i punti estremali (massimo, minimo o sella): si cerca cioè quale sia, tra tutti i possibili, il percorso q che rende minimo l'integrale S(q) fissati i punti iniziale e finale.
Nota: si parla di Principio di minima azione poiché, nel caso del moto meccanico, la condizione δS=0 individua un minimo per l'azione S.

Questa condizione si traduce quindi nella seguente equazione:
δS(q)=δ∫t1t2L(q,q')dt=∫t1t2δL(q,q')dt=0
dove
δL(q,q')=(∂L/∂q)δq+(∂L/∂q')δq'
è l'analogo del differenziale di una funzione F(x,y) a due variabili (si ricordi infatti che dF(x,y)=(∂F/∂x)dx+(∂F/∂y)dy); inoltre si è posto δq'=dδq/dt.

Prima di sviluppare l'integrale è utile fare la derivata, rispetto al tempo, del termine (∂L/∂q')δq:
d(∂L/∂q')δq/dt=δqd(∂L/∂q')/dt+(∂L/∂q')δq'
da cui si ricava facilmente il termine (∂L/∂q')δq' che useremo di seguito:
(∂L/∂q')δq'=d(∂L/∂q')δq/dt-δqd(∂L/∂q')/dt.

Possiamo quindi inserire nell'integrale di δS(q) il valore di δL(q,q') prima definito (sostituendo poi il termine (∂L/∂q')δq' appena ricavato); si ottiene:
δS(q)=∫t1t2δL(q,q')dt=∫t1t2[(∂L/∂q)δq+(∂L/∂q')δq']dt=
=∫t1t2(∂L/∂q)δqdt+∫t1t2[d(∂L/∂q')δq/dt]dt-∫t1t2[δqd(∂L/∂q')/dt]dt.

Si osservi che il secondo termine a destra dell'equazione è nullo risultando:
∫t1t2[d(∂L/∂q')δq/dt]dt=[(∂L/∂q')δq]t1t2=0
avendo posto come condizione al contorno δq(t1)=δq(t2)=0 (poiché i punti iniziale e finale del percorso non variano).

Perciò se vogliamo che il δS sia nullo dovremo porre (raccogliendo δqdt dal primo e terzo termine dell'equazione di δS(q)):
δS(q)=∫t1t2[(∂L/∂q)-d(∂L/∂q')/dt]δqdt=0
ciò significa che il termine sotto integrale deve essere nullo (essendo δq≠0):
∂L/∂q-d(∂L/∂q')/dt=0.
Questa è proprio l'equazione, detta di Eulero-Lagrange, che L(q,q') deve soddisfare per il Principio di minima azione** e che rappresenta l'equazione del moto del sistema (l'analogo per la meccanica di F=mq'').

Ma a questo punto resta una domanda fondamentale, come è fatta la lagrangiana L(q,q') di un sistema dinamico qualsiasi?

Ebbene si ipotizza che ogni sistema fisico abbia la propria lagrangiana***. Ad esempio nel caso di sistemi meccanici si pone (e se ne può verificare per via sperimentale la validità):
L(q,q')=T(q')-V(q)
dove T(q') è l'energia cinetica del sistema (che dipende dalla velocità q') e V(q) è l'energia potenziale (funzione della posizione q).
In particolare ricordiamo che per una particella di massa m risulta:
T(q')=mq'2/2   e   -∂V(q)/∂q=F(q) 
dove F(q) è la forza a cui è sottoposta la particella lungo il percorso.
Nota: anche nel caso non conservativo dove non è definibile un potenziale (ad esempio per il campo magnetico), possiamo introdurre una funzione L(q,q') che soddisfi il principio di minima azione.

Si noti che tale equazione è equivalente a quella del moto di Newton: F=mq'' (dove q'' è l'accelerazione impressa alla particella dalla forza F); per mostrarlo basta inserire L=T(q')-V(q) nell'equazione di Eulero-Lagrange e poi derivare (ricordando che T dipende solo da q' mentre V dipende da q):
∂L/∂q-d(∂L/∂q')/dt=-∂V/∂q-d(∂T/∂q')/dt=F-mq''=0.
(Per approfondimenti vedi il seminario sul Principio di minima azione di Arrigo Amadori).

(*) L'introduzione della funzione L(q,q') è dovuta a Lagrange ed è apparsa nel suo libro "Méchanique Analitique" nel 1788 scritto proprio con lo scopo di ridurre la teoria meccanica ad operazioni algebriche, senza ragionamenti geometrici o meccanici (in effetti il libro non contiene figure).
(**) Il Principio di minima azione è un principio locale (essendo espresso da una equazione differenziale) e quindi la scelta del percorso viene definita puntualmente, istante per istante, senza nessun tipo di finalismo.
(***) Sembra che tutte le leggi fondamentali della fisica possano essere scritte nei termini di una lagrangiana. Ad esempio L=(g)1/2(R-(1/2)FµvFµv-ψ*Dψ) descrive un sistema dinamico di particelle come elettroni e quark, soggette a gravità, campi elettromagnetici e forze nucleari.

mercoledì 23 maggio 2018

Trasformazioni di basi, vettori e... co-vettori!

Come avevamo già osservato nel post "Cos'è il Vettore di Posizione?" la definizione di vettore non dipende dal sistema di coordinate prescelto e quindi, se vogliamo trasformare le coordinate rispetto alle quali quel vettore è definito, saranno le sue componenti a variare* in modo che il vettore resti invariato in modulo e direzione.

È noto che un qualsiasi vettore V può essere descritto come la combinazione lineare delle sue componenti vi moltiplicate per le rispettive basi vettoriali ei (cioè l'insieme dei vettori che generano lo spazio vettoriale); ad esempio nel caso più semplice di uno spazio bidimensionale avremo:
V=e1v1+e2v2.
Nota: vedremo più avanti il significato fisico degli indici in apice e pedice, diciamo che per ora indicano le due diverse basi (vettori) e rispettive componenti (qui gli apici non indicano mai elevamenti di potenza!)

Nel caso perciò di una trasformazione di coordinate si avrà un cambio delle basi ei (indicate dal trattino sotto) a cui corrisponde un cambio delle rispettive componenti vi (anch'esse indicate dal trattino sotto) in modo che il vettore V resti invariato, cioè:
V=e1v1+e2v2.

Se usiamo il formalismo matriciale, possiamo indicare le componenti di V come una matrice colonna, mentre le basi sono rappresentate da una matrice riga; moltiplicandole tra loro si ottiene (per l'invarianza di V):
Nota: ricordiamo che il prodotto tra due matrici tipo (m,n)x(n,p) produce una matrice (m,p) sviluppando il prodotto righe per colonne.

Supponiamo ora che le basi di V si trasformino secondo una generica matrice di trasformazione A (matrice quadrata 2x2 e invertibile in A-1):
allora affinché si ottengano di nuovo le equazioni di V sopra espresse, dovrà risultare per la trasformazione delle componenti:
infatti moltiplicando tra loro (membro a membro) le due ultime equazioni, si ottiene di nuovo l'identità V=V (essendo AxA-1=I la matrice identità).
Nota: abbiamo implicitamente supposto, con l'introduzione della matrice di trasformazione A, una relazione lineare tra le componenti (come vedremo ciò è sempre vero per le coordinate in forma differenziale).

Dato il ruolo diretto della matrice A si dice che le basi vettoriali di V si trasformano in modo covariante, mentre le sue componenti, che viceversa dipendono dalla sua inversa A-1, si trasformano in modo controvariante.
Nota: per convenzione le basi vettoriali (e1,e2) che si trasformano in modo covariante si indicano con il pedice mentre le componenti controvarianti del vettore (v1,v2) si indicano con l'apice.

Quando la matrice A di trasformazione è ortogonale (come nel caso di una rotazione di assi cartesiani ortogonali)** allora per definizione vale la relazione A-1=AT (dove AT è la matrice trasposta) da cui segue, facendo la trasposta di tutta la precedente equazione:
Nota: ricordiamo che la trasposta di un vettore colonna è un vettore riga (e viceversa); inoltre risulta per la trasposta AT: (AT)T =A.

Si noti però che questa ultima espressione è formalmente identica alla trasformazione covariante delle basi e quindi (in questo caso) la distinzione tra trasformazione covariante e controvariante decade; inoltre quando la trasformazione è ortogonale si conserva il prodotto scalare tra vettori.
Nota: è per tale motivo che nella fisica classica non si parla quasi mai dei due tipi di trasformazione, è sufficiente quella covariante.

Tuttavia nel caso più generale di una trasfomazione di coordinate qualunque (non ortogonale) ci chiediamo: come si trasformano le componenti di un vettore affinché questo resti invariato e quindi il prodotto scalare si conservi? Per quanto visto sopra ciò equivale a chiedersi com'è fatta in generale la matrice di trasformazione A e la sua inversa A-1.
Nota: se il modulo di un vettore è invariato allora anche il prodotto scalare resta invariato (dato che il modulo è la radice del vettore per se stesso).

Consideriamo ad esempio il caso classico di un lavoro infinitesimo dL (dovuto ad una forza F impressa ad un corpo che si sposta di un tratto infinitesimo ds), che è così definito nel caso bidimensionale:
dL=Fds=F1dx1+F2dx2.
Vogliamo che questo prodotto scalare tra vettori si conservi rispetto ad un sistema di coordinate qualunque, come in effetti accade nella realtà fisica (dato che il prodotto vettoriale Fds determina un invariante scalare).
Nota: invece delle classiche coordinate (x,y) abbiamo posto x=x1 e y=x2 (vedremo più avanti il significato degli indici messi in apice o pedice).

Consideriamo quindi una trasformazione di coordinate qualsiasi: trasformiamo ad esempio le coordinate (x1,x2) in quelle di un nuovo sistema (x1,x2) (dove le nuove coordinate sono note in funzione delle prime):
x1=x1(x1,x2)   ;   x2=x2(x1,x2)
ed inoltre esse devono ammettere la trasformazione inversa (affinché si possa passare da un sistema all'altro):
x1=x1(x1,x2)   ;   x2=x2(x1,x2).
Nota: per ipotesi tali funzioni sono differenziabili (funzioni lisce).

Per le note formule del calcolo differenziale di una funzione si ha:
dx1=(∂x1/∂x1)dx1+(∂x1/∂x2)dx2   e   dx2=(∂x2/∂x1)dx1+(∂x2/∂x2)dx2
possiamo quindi riscrivere il dL=F1dx1+F2dx2 sostituendo dx1 e dx2:
dL=F1(∂x1/∂x1)dx1+F1(∂x1/∂x2)dx2+F2(∂x2/∂x1)dx1+F2(∂x2/∂x2)dx2.

Se ora raccogliamo rispetto a dx1 e dx2 risulta:
dL=[F1(∂x1/∂x1)+F2(∂x2/∂x1)]dx1+[F1(∂x1/∂x2)+F2(∂x2/∂x2)]dx2
e il dL può essere riscritto nel nuovo sistema di coordinate:
dL=Fds=F1dx1+F2dx2
avendo posto
F1=F1(∂x1/∂x1)+F2(∂x2/∂x1)
F2=F1(∂x1/∂x2)+F2(∂x2/∂x2)
ed essendo per le solite formule differenziali
dx1=(∂x1/∂x1)dx1+(∂x1/∂x2)dx2 
dx2=(∂x2/∂x1)dx1+(∂x2/∂x2)dx2.
Nota: come richiesto, con queste trasformazioni il lavoro infinitesimo dL resta invariato nel cambio di coordinate.

Le derivate parziali (∂xi/∂xj) e (∂xj/∂xi) rappresentano perciò gli elementi, rispettivamente, della matrice di trasformazione A ed A-1 per F e per ds (dove A-1 è detta matrice jacobiana di solito indicata con J).
Nota: quindi (F1,F2) si trasforma in modo covariante mentre (dx1,dx2) in modo controvariante, come accade per basi e componenti di un vettore.

In definitiva possiamo scrivere per le componenti di F e ds (si sottintende il simbolo di sommatoria con la notazione di Einstein sugli indici ripetuti):
Fj=Fi(∂xi/∂xj)   e   dxj=dxi(∂xj/∂xi)
(con i, j=1, 2) grazie alle quali il prodotto scalare resta invariato e quindi, come già notato, anche il modulo di un vettore resta invariato (poiché è la radice del vettore moltiplicato per se stesso).

Perciò la legge generale di trasformazione delle componenti Ai di un vettore, che chiameremo covariante (o covettore) e quelle Bi del rispettivo vettore controvariante, tale per cui il prodotto scalare C=AiBi=AjBj si conservi, è la seguente (come mostrato sopra per Fj e dxj):
Aj=Ai(∂xi/∂xj)   e   Bj=Bi(∂xj/∂xi)
con la solita regola di sommatoria sugli indici ripetuti con i, j=1, 2, ... n (dove per convenzione gli apici indicano le componenti di un vettore mentre i pedici quelle di un covettore).
Note: in questo modo qualsiasi prodotto scalare tra un vettore A e il relativo covettore B è un invariante per trasformazioni di coordinate.

Ora nel contesto matriciale di un prodotto scalare, le componenti Ai di un vettore riga definiscono un covettore (o vettore covariante) che, applicato a un vettore colonna (o vettore controvariante) di componenti Bi, produce C=AiBi cioè un elemento scalare (del campo K) dallo spazio vettoriale V: l'insieme dei covettori (o funzionali f:V->K) definisce lo spazio duale***.
Nota: ricordiamo che il prodotto scalare tra A e B viene spesso indicato come <A,B> e che vettori e covettori sono legati dal tensore metrico gij=<ei,ej> (dove <ei,ej> è il prodotto scalare tra le basi) da cui Ai=gijAj.
[Infatti risulta
gijAj=<ei,ej>Aj=<ei,ejAj>=<ei,A>=Ai ma anche gijAi=Aj]

(*) Non sempre coordinate e componenti coincidono, nel caso ad esempio di coordinate curvilinee angolari queste non corrispondono alle componenti di un vettore, essendo quest'ultime delle lunghezze.
(**) Una trasformazione ortogonale viene espressa rispetto ad una base ortonormale (come ad esempio quella canonica degli assi cartesiani), tramite una matrice ortogonale e quindi invertibile.
(***) Data ad esempio la base canonica e1=(1,0)T, e2=(0,1)T (vettori colonna) possiamo definire una base canonica duale come e1=(1,0), e2=(0,1) (vettori riga) che rispetta la condizione generale di dualità <ei,ej>=δij (con δij delta di Kronecker); per un qualsiasi vettore V risulta perciò: V=eivi=ejvj.
[Si pone <ei,ej>=δij affinché risulti correttamente: <A,B>=(eiAi)(ejBj)=AiBi]

(Si vedano anche le lezioni di Arrigo Amadori).